关于XLua与C#之间的通信分析

分析了一下XLua与C#之间的通信方式,发现和SLua,Ulua的区别不是很大。

Lua调用C#:

都是需要先生成一个个wrap文件,C#才能被lua调用。

wrap文件相当于一个接口,Lua先调用 wrap文件 然后 wrap 再调用C#,在 wrap 文件里面实际上是把C#的类函数,字段压入到lua虚拟机的虚拟栈上,再由lua虚拟机出栈后给lua调用的。

当索引系统API、dll库或者第三方库时,无法将代码的具体实现进行代码生成,采用C#的反射方式实现交互,缺点是执行效率低。

也就是说Lua调用C#其实就是:lua->wrap->C#

那么在XLua中C#又是如何调用Lua的呢?

看源码很容易知道,其实是使用如下函数:

 LuaEnv luaenv = new LuaEnv();//创建Lua虚拟机
 luaenv.DoString("CS.UnityEngine.Debug.Log('hello world')");执行lua代码

根据XLua的文档,DoString可以直接执行字符串代码,也可以加载lua文件执行,

分析源码发现DoString其实是调用的外部DLL中的xluaL_loadbuffer函数,如下 DoString 定义:

public object[] DoString(byte[] chunk, string chunkName = "chunk", LuaTable env = null)
        {
#if THREAD_SAFE || HOTFIX_ENABLE
            lock (luaEnvLock)
            {
#endif
                var _L = L;
                int oldTop = LuaAPI.lua_gettop(_L);
                int errFunc = LuaAPI.load_error_func(_L, errorFuncRef);
                if (LuaAPI.xluaL_loadbuffer(_L, chunk, chunk.Length, chunkName) == 0)
                {
                    if (env != null)
                    {
                        env.push(_L);
                        LuaAPI.lua_setfenv(_L, -2);
                    }

                    if (LuaAPI.lua_pcall(_L, 0, -1, errFunc) == 0)
                    {
                        LuaAPI.lua_remove(_L, errFunc);
                        return translator.popValues(_L, oldTop);
                    }
                    else
                        ThrowExceptionFromError(oldTop);
                }
                else
                    ThrowExceptionFromError(oldTop);

                return null;
#if THREAD_SAFE || HOTFIX_ENABLE
            }

而 xluaL_loadbuffer 外部引入声明如下:

 [DllImport(LUADLL, CallingConvention = CallingConvention.Cdecl)]
 public static extern int xluaL_loadbuffer(IntPtr L, byte[] buff, int size, string name);

也就说xluaL_loadbuffer的函数实现并不在源文件中,而是在外部DLL文件中实现的。

继续查找发现它其实是xlua.dll里面的函数,在 xlua.dll 源码xlua.c文件中发现如下定义:

LUALIB_API int xluaL_loadbuffer (lua_State *L, const char *buff, int size,
                                const char *name) {
	return luaL_loadbuffer(L, buff, size, name);
}

根据文件后缀,其实它就是C代码,而且调用的luaL_loadbuffer其实就是lua源码里面的函数。Xlua只是把它封装了一下而已。

继续查找Lua源码,分析Lua.5.3.3的源码发现xluaL_loadbuffer 其实是调用了 lua_load 函数,而 lua_load 实现如下:

LUA_API int lua_load (lua_State *L, lua_Reader reader, void *data,
                      const char *chunkname, const char *mode) {
  ZIO z;
  int status;
  lua_lock(L);
  if (!chunkname) chunkname = "?";
  luaZ_init(L, &z, reader, data);
  status = luaD_protectedparser(L, &z, chunkname, mode);
  if (status == LUA_OK) {  /* no errors? */
    LClosure *f = clLvalue(L->top - 1);  /* get newly created function */
    if (f->nupvalues >= 1) {  /* does it have an upvalue? */
      /* get global table from registry */
      Table *reg = hvalue(&G(L)->l_registry);
      const TValue *gt = luaH_getint(reg, LUA_RIDX_GLOBALS);
      /* set global table as 1st upvalue of 'f' (may be LUA_ENV) */
      setobj(L, f->upvals[0]->v, gt);
      luaC_upvalbarrier(L, f->upvals[0]);
    }
  }
  lua_unlock(L);
  return status;
}

上述代码中调用了luaD_protectedparser来进行parse过程, 在luaD_protectedparser中又调用了f_parser ,在f_parser中根据一些选择来分别处理不同的情况,这就是lua的词法语法语义分析过程。

从上述分析发现,其实C#调用lua,就是C#先调用C代码,然后C调用lua的过程,因为Lua的源码是C写的,lua的代码需要Lua虚拟机解释执行,也就是需要C代码来解析执行。


递归实现斐波那契数列

递归的定义:把一个直接调用自己或通过一系列的调用语句间接的调用自己的函数,叫做递归函数。

斐波那契数列定义如下:
{ 0                        n=0
f(n){ 1                        n=1
{ f(n-1)+f(n-2)    n>1

   public int fbnq(int n)
   {
          if(n < 0)
	     return 0;
	  if (n < 2){
             return n;
	  }
	  else{
	     return fbnq(n - 1) + fbnq(n - 2);
	  }
    }

c#实现KMP算法的优化

KMP算法是有三位前辈提出来的一个模式匹配算法,也就是从一个字符串中查找子串的算法,类似C#里面 indexOf ()函数的功能。

如果利用普通的匹配算法去查找子串,最坏的情况下算法复杂度是O((n-m+1)*m) n代表的主串的长度,m代表的是子串的长度,很显然这个算法比较低效。

所以就有大神们发明了KMP算法,它的原理是比普通的匹配算法节省了比对步骤,如主串m=”abcababca”,子串s=”abcabx”,前5个字符是相同的第6个字符不等,那么可以判断子串s中的第一个字符和主串中的第二个,第三个字符也不相等。KMP算法正是省略这些可以判断步骤达到优化匹配算法的目的。

代码如下:

using System;
using System.Collections.Generic;
using System.Linq;
using System.Text;
using System.Threading.Tasks;

namespace KMP
{
    class Program
    {
        //计算出子串返回的next数组,当子串不匹配时根据next数组值进行回溯
        static void GetNext(string p, int []next){
            int len = p.Length;
            int i = 0;
            int j = -1;
            next[0] = -1;
            while (i < len)
            {
                if (j == -1 || p[i] == p[j]){
                    ++j;
                    ++i;
                    next[i] = next[j];
                }
                else{
                    j = next[j];//若字符不相同,则j值回溯
                }
            }
        }

        static int Main(string[] args)
        {
            string str = "abccc aabb";
            string sub = "abb";
            int []next = new int[100];
            //计算出子串返回的next数组
            GetNext(sub, next);
            int i = 0;
            int j = 0;
            while (i < str.Length && j < sub.Length) {
                if (j == -1 || str[i] == sub[j] )
                {
                    ++i;
                    ++j;
                }
                else
                    j = next[j];//j回溯到合适的位置
            }
            if (j == sub.Length)
            {
                Console.WriteLine(i - j);
                Console.ReadKey();
                return i - j;
            }
            return 0;
        }
    }
}
  

KMP算法的优化:

后来有人发现上面的KMP算法还是有缺陷的,比如主串m=”aaaabcde” ,子串s=”aaaaax”,由于子串的前面4个字符和主串都是相等的,那么可以用首位next[1]的值去取代与它相等的字符后续的next[j]的值,因此可以对获取next数组的函数进行改良。

static void GetNext(string p, int []next){
            int len = p.Length;
            int i = 0;
            int j = -1;
            next[0] = -1;
            while (i < len)
            {
                if (j == -1 || p[i] == p[j]){
                    j++;
                    i++;
                    if (i < len && p[i] != p[j])
                        next[i] = j;
                    else
                        next[i] = next[j];//改良部分
                }
                else{
                    j = next[j];
                }
            }
        }

设计模式-观察者模式

观察者模式属于23种GOF设计模式里的行为模式,行为模式特别关注对象之间的通信。

目的:定义对象间的一种一对多的依赖关系,以便当一个对象的状态发生改变时,所有依赖于它的对象都得到通知并自动更新。

结构图

组成:

(1)、抽象主题角色(Subject):抽象主题把所有观察者对象的引用保存在一个列表中,并提供增加和删除观察者对象的操作,抽象主题角色又叫做抽象被观察者角色,一般由抽象类或接口实现。

(2)、抽象观察者角色(Observer):为所有具体观察者定义一个接口,在得到主题通知时更新自己,一般由抽象类或接口实现。

(3)、具体主题角色(ConcreteSubject):实现抽象主题接口,具体主题角色又叫做具体被观察者角色。

(4)、具体观察者角色(ConcreteObserver):实现抽象观察者角色所要求的接口,以便使自身状态与主题的状态相协调。

设计模式-组合模式

组合模式属于23种GOF设计模式种的结构型模式。

目的: 将对象组合成树形结构以表示“部分-整体”的层次结构。组合模式使得用户对单个对象和组合对象的使用具有一致性。

结构图

组成

(1)、抽象构件角色(Component):这是一个抽象角色,它给参加组合的对象定义出了公共的接口及默认行为,可以用来管理所有的子对象(在透明式的组合模式是这样的)。在安全式的组合模式里,构件角色并不定义出管理子对象的方法,这一定义由树枝结构对象给出。

(2)、树叶构件角色(Leaf):树叶对象是没有下级子对象的对象,定义出参加组合的原始对象的行为。(原始对象的行为可以理解为没有容器对象管理子对象的方法,或者 【原始对象行为】+【管理子对象的行为(Add,Remove等)】=面对客户代码的接口行为集合)

(3)、树枝构件角色(Composite):代表参加组合的有下级子对象的对象,树枝对象给出所有管理子对象的方法实现,如Add、Remove等。

设计模式-适配器模式

在23种GOF设计模式中适配器模式属于结构型模式,结构型模式的意思是这些设计模式关注的是类和对象的组合关系。

目的: 将一个类的接口转换成客户希望的另一个接口。适配器模式使得原本由于接口不兼容而不能一起工作的那些类可以一起工作。

结构图

组成

(1)、目标角色(Target):定义Client使用的与特定领域相关的接口。
   
(2)、客户角色(Client):与符合Target接口的对象协同。
 
(3)、被适配角色(Adaptee):定义一个已经存在并已经使用的接口,这个接口需要适配。
(4)、适配器角色(Adapte) :适配器模式的核心。它将对被适配Adaptee角色已有的接口转换为目标角色Target匹配的接口。对Adaptee的接口与Target接口进行适配.

反转单链表,递归实现

ListNode * reverseList(ListNode * list) {
if ( list == NULL || list ->next == NULL) //链表为空直接返回,而 list ->next为空是递归基
return list;
ListNode * newHead = reverseList( list ->next); //一直循环到链尾
list ->next->next = list ; //翻转链表的指向
list ->next = NULL; //记得赋值NULL,防止链表错乱
return newHead; //新链表头永远指向的是原链表的链尾
}

海明码的编码和校验方法

海明码(也叫汉明码)具有一位纠错能力,只能纠错一位。本文以1010110这个二进制数为例解释海明码的编码和校验方法。

  编码

  确定校验码的位数x

  设数据有n位,校验码有x位。则校验码一共有2x种取值方式。其中需要一种取值方式表示数据正确,剩下2x-1种取值方式表示有一位数据出错。因为编码后的二进制串有n+x位,因此x应该满足

2x-1 ≥ n+x   

  使不等式成立的x的最小值就是校验码的位数。在本例中,n=7,解得x=4。

  确定校验码的位置

  校验码在二进制串中的位置为2的整数幂。剩下的位置为数据。如图所示。

位置1234567891011
内容x1x21x3010x4110

  求出校验位的值

  以求x2的值为例。为了直观,将表格中的位置用二进制表示。

位置00010010001101000101011001111000100110101011
内容x1x21x3010x4110

  为了求出x2,要使所有位置的第二位是1的数据(即形如**1*的位置的数据)的异或值为0。即x2^1^1^0^1^0 = 0。因此x2 = 1。

  同理可得x1 = 0, x3 = 1, x4 = 0。

位置00010010001101000101011001111000100110101011
内容01110100110

  因此1010110的海明码为01110100110。

  校验

  假设位置为1011的数据由0变成了1,校验过程为:

  将所有位置形如***1, **1*, *1**, 1***的数据分别异或。

  ***1: 0^1^0^0^1^1 = 1

  **1*: 1^1^1^0^1^1 = 1

  *1**: 1^0^1^0 = 0 

  1***: 0^1^1^1 = 1

  以上四组中,如果一组异或值为1,说明该组中有数据出错了。***1 **1* 1***的异或都为1,说明出错数据的位置为1011。

egret踩坑,http请求返回IOError问题解决

这几天用白鹭引擎做游戏开发的时候用到了白鹭自带的HTTP请求API发现在请求自己的阿里云服务器的时候,API始终返回IOError错误,网上找了很多资料,也没有一个正面的回答.最后自己一遍遍尝试,终于发现.原来是服务器跨域的问题.

例如使用:

var request = new egret.HttpRequest(); request.responseType = egret.HttpResponseType.TEXT;
request.open(“https://huangyi.cc”,egret.HttpMethod.GET);
request.setRequestHeader(“Content-Type”, “application/x-www-form-urlencoded”);
request.send();
request.addEventListener(egret.Event.COMPLETE,this.onGetComplete,this);
request.addEventListener(egret.IOErrorEvent.IO_ERROR,this.onGetIOError,this);
request.addEventListener(egret.ProgressEvent.PROGRESS,this.onGetProgress,this);

使用上面的代码进行http访问https://huangyi.cc域名,假如此域名的服务器没有允许跨域访问,则白鹭的API会返回IO_ERROR错误也就是会执行this.onGetIOError函数.

这个时候就要修改服务器的配置比如在nginx服务器上:

Linux下找到nginx的配置文件然后用VI编辑器编辑它.

vi /etc/nginx/nginx.conf

加入如下代码

http {
  ###start####
  add_header Access-Control-Allow-Origin *;
  add_header Access-Control-Allow-Headers X-Requested-With;
  add_header Access-Control-Allow-Methods GET,POST,OPTIONS;
  ###end ###
}

:wq!保存

service nginx restart 重启nginx即可。

在apache服务器上如下配置:

1.首先找到 httpd.conf 文件

找到 #LoadModule headers_module modules/mod_headers.so

把#注释符去掉(也有可能已经默认去掉了)

目的是开启apache头信息自定义模块

2.找到你的虚拟主机文件 注意是被跨域的网站的 具体内容是这样的文件


<Directory "E:/laragon/www/(你的本地地址)">
    AllowOverride All
    Require all granted
</Directory>

然后在这段内容里面加上如下:

对所有域名开放

Header set Access-Control-Allow-Origin * (这样加上一行)

对指定域名开放

Header set Access-Control-Allow-Origin http://www.***.com (或者这样加上一行)

OK,跨域问题搞定

3D游戏世界里的万向节锁

我们通常认为当前世界是一个三维的世界,用坐标系来表示就是XYZ,在3D游戏世界里也是用这样的三维坐标系来表示的。


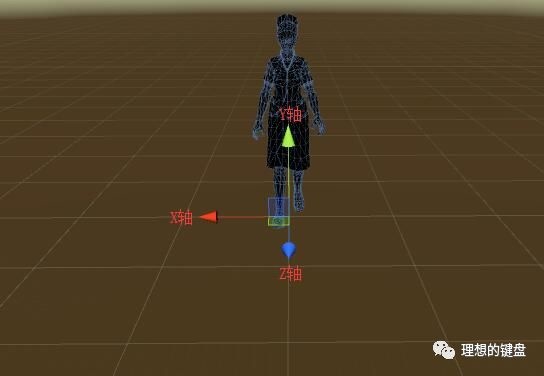
X代表水平坐标,Y代表垂直坐标,Z代表的是由屏幕往里的一个深度坐标,也就是垂直于屏幕的坐标轴。

如下图,在一个3D世界里,绿色代表Y坐标,红色代表X坐标,而垂直于屏幕的蓝色是Z坐标。


这样在一个3D世界里面就可以方便的表示一个物体的位置信息和旋转信息。

那么什么是万向节锁?

其实就是一个物体在一个3D世界里面随着旋转顺序和旋转角度的改变,导致物体只能在一个固定的平面旋转,无法旋转到你预想的角度。

由于物体的旋转,物体的坐标轴方向也发生了改变,导致其中2条坐标轴发生了重合

当你围绕着重合的坐标轴旋转时,物体的旋转方向始终在一个平面上旋转。

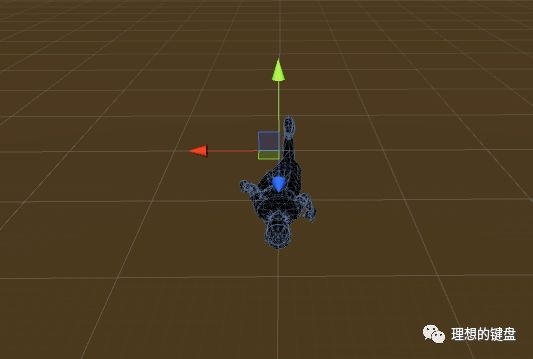
比如在Unity3D 中我们把一个物体按照先沿X轴旋转90度。


3D世界里面的人物沿X轴旋转了90度,人物的头看向了下方也就是Y轴的反方向。

此时物体的坐标轴也发生了改变,那么是哪个轴发生了改变呢?

可以自行想象一下。

其实只有Y轴发生了改变,由于物体围绕X旋转了90度,那么这个时候的Y轴也围绕X旋转了90度,也是和原来的Z轴重合了,原来的Y轴是由人物的脚指向头这个方向的,当人物围绕X轴旋转90度后。

Y轴还是按照由人物的脚的方向指向了头,也就刚好是垂直于屏幕的。

这样就导致了,当前的Y轴和原来的Z轴重合了。

这个时候你可能会想既然Y轴改变了,Z轴也会改变啊,原来的Z轴是从人物的身体由屏幕外指向屏幕里的,那么当物体围绕X轴旋转后,那么此时Z轴还是应该由人物的身体穿过人物的背面,也就是当前的绿色坐标轴。

按照我们的社会经验物体围绕X轴旋转90度后,Z轴和Y轴只是交换了位置而已啊。

但是其实在3D游戏世界里面不是这样去定义的。

而是按照陀螺仪的原理去解释的。

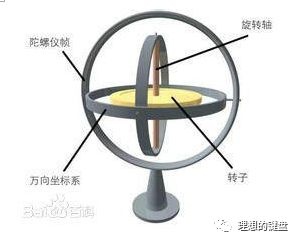
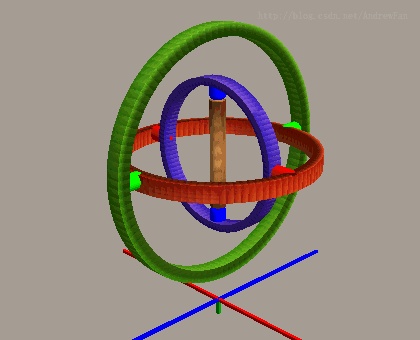
我们看下图,一个陀螺仪装置:


陀螺仪的装置非常简单,中间有一根竖轴,穿过一个圆盘。

圆盘称为转子,竖轴称为旋转轴。转子用金属制成,增加质量,从而增大惯性。竖轴外侧是三层嵌套的圆环,它们互相交叉,带来了三个方向自由度的旋转。

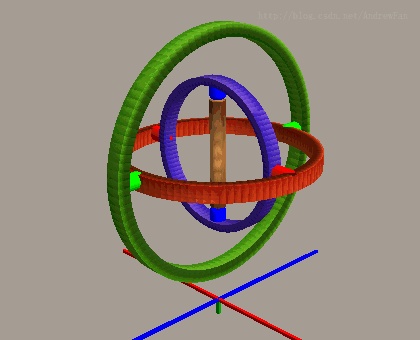
简单分解后就是如下图:


假如把绿色圆盘的转轴称作为Y轴,红色圆盘的转轴称作为X轴,蓝色圆盘的转轴称作为Z轴。

那么当绿色圆盘围绕它的转轴旋转时,并不会改变红色和蓝色旋转轴方向的变化。


当红色圆盘围绕着它的转轴旋转时,绿色圆盘的转轴方向发生了改变。


当蓝色的圆盘围绕着它的转轴旋转时,绿色和蓝色的转轴方向都发生了改变。


当红色圆盘围绕转轴旋转90度后


绿色圆盘的转轴和蓝色圆盘的转轴重合了,而红色圆盘的转轴方向并没有改变,这个时候就发生了万向节死锁现象。

绿色圆盘的旋转和蓝色圆盘的旋转都在同一个平面上旋转了,只要红色圆盘不发生改变,不管如何旋转绿色和蓝色圆盘都无法解除这种状态。

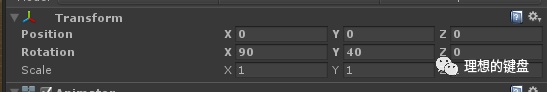
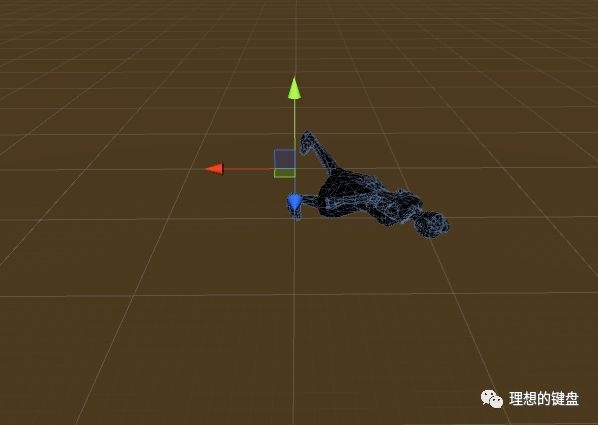
如在Unity3D中当把物体旋转围绕X轴旋转90度后。

把人物围绕Y轴再旋转40度后:


把人物围绕Z轴再旋转40度后:


我们发现物体不管是围绕Y轴还是Z轴旋转,都只是在一个平面旋转,而不是不同的平面了。

如果开始只把物体围绕X轴旋转89度的话,结果又会不同了。